🚀 Release: tlc-spec-driven 4 e tlc-spec-lean 2: Melhorias de Frontend, Compactação, Performance e...
Conforme os modelos melhoram nossas skills precisam evoluir para tirar proveito. Este release melhora o harness em duas frentes que os modelos atuais já conseguem aproveitar, frontend e compactação de contexto, e deixa a verificação bem mais barata.
Frontend. Os modelos de hoje já escrevem e conferem telas bem, desde que alguém cobre o resultado. As skills agora tratam o design anexado como contrato e fotografam cada estado no tamanho da captura. Um juiz independente compara a tela com o design item por item, e "pronto" só vale quando a tela bate.
Compactação. Os modelos de hoje lidam bem com janelas longas, começa a virar normal trabalhar em janelas de 300k/500k e deixar chegar a 100%. Então uma run que segue depois de compactar o contexto passa a valer mais do que parar e recomeçar. As skills agora guardam em arquivo tudo o que a conversa levaria embora: a sua aprovação, com as suas palavras; as respostas, no turno em que chegam; cada subagente despachado. Depois de compactar, o agente retoma do ponto certo, sem refazer trabalho e sem duplicar verificação.
Performance e consumo. A verificação era a fase mais cara, e foi a que mais encolheu. Ninguém mais refaz prova à mão:
um script roda todas as provas, o build e o lint de uma vez, em segundos;
o Verifier gasta o tempo dele só julgando e injetando mutações;
o juiz de telas olha só os estados que uma captura desenha e não lê o código;
são no máximo duas rodadas, e a segunda reabre só o que divergia.
No nosso benchmark, a verificação da lean caiu de ~63 min para ~9 a 25 min, conforme o modelo, e a da spec-driven de ~15 para ~10 min. A spec-driven ainda subiu de 84.3 para 98.5 pontos no mesmo tempo total. As instruções também ficaram mais curtas, e o agente gasta menos contexto lendo o processo.
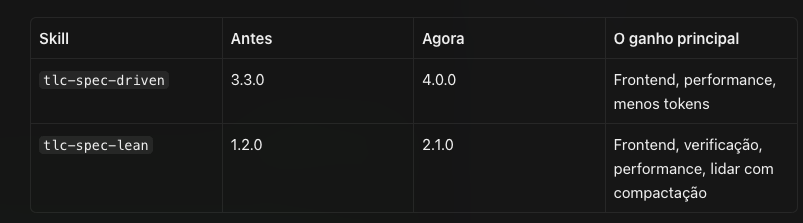
tlc-spec-driven 4.x
Para que serve: planejar e implementar uma feature em fases (Specify, Design, Tasks, Execute), com a profundidade ajustada ao tamanho do trabalho.
Quando usar: Spec Driven clássico, onde cada etapa precisa ser revisitada e ajusta, comum e modelos medianos onde o harness tem que exigir disciplina. E também código legado onde é necessário um design detalhado para ajustes.
O que muda para você
Pergunta em vez de supor. Toda decisão de produto vira pergunta antes da spec, e você aprova duas vezes: a spec e as tasks. Na 3.3.0 o agente supunha e seguia.
Verificação mais simples. Um script roda todas as provas, o build e o lint de uma vez; o Verifier só julga e injeta mutações. São no máximo duas rodadas, e a verificação caiu de ~15 para ~10 min.
Tela conferida pelo juiz. Ele abre o app no tamanho da captura e tira as próprias fotos.
Menos instrução. ~15% menor, sem modos de ritmo, sem a pergunta de MCPs e sem tabelas impressas.
Respeita o .gitignore: a spec não entra no commit à força.
Breaking changes: o tasks.md ganha ## Checks com uma linha Proof: por check, mais Build: e Mutations:. O spec.md e o tasks.md ganham a linha Approved:. Saem validate_state.py, context-limits.md e code-analysis.md.
tlc-spec-lean 2.x
Para que serve: a mesma entrega com menos cerimônia. Um plano que você aprova, checks com prova, o build e um Verifier independente.
Quando usar: Versão enxuta da tlc-spec-driven para modelos frontier como Opus, Fable, Astra, Sol, Grok, Sonnet. Modelos que não precisam de babbysitting. Ela foca em dar o problema e depois verificar.
O que muda para você
Pergunta em vez de supor. Antes ela podia assumir um default; agora toda decisão de produto vira pergunta antes do plano.
Um nível de verificação só. Os perfis light, standard e ui saíram. Toda feature tem um script com as provas e o build com mutações e o juiz de telas otimizados.
Plano mais fácil de revisar. Diagramas mermaid do caminho e dos dados, larguras de tela perguntadas, e cada frase do pedido cai num critério, num "fora de escopo" ou numa pergunta.
Relato honesto. O relato final abre com o resultado do gate.
Breaking changes: o plan.md ganha a linha Approved:. O checks.md ganha Build: e Mutations: (de 0 a 5). O screens.md ganha Round: e HEAD:. Saem o perfil, a Test policy e o cálculo de budget e handoff.
Nota: a tlc-plan e a tlc-implement, nossas skills em beta que dividem a lean em planejar e construir, foram atualizadas junto com ela e seguem as mesmas regras. Ainda não esta definido se vamos manter elas oficialmente, sugerimos usar a lean que esta estável.
Resultados
Benchmark: uma feature de tela com três designs anexados, rubrica de 100 pontos (escopo, design, qualidade, robustez e entrega), respostas de produto fixas, uma run por configuração.
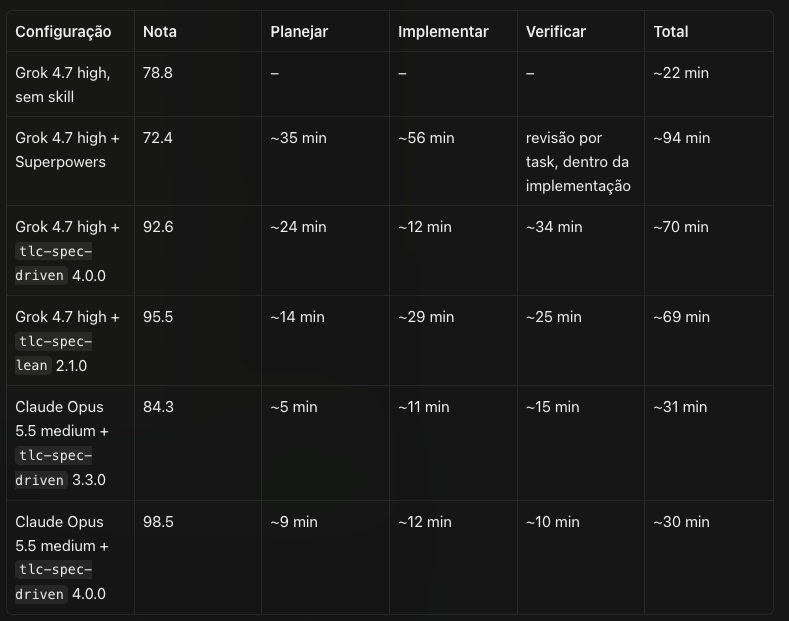
O tempo de planejar inclui as perguntas e as aprovações; as respostas vieram em segundos, então quase todo esse tempo é do agente. A run sem skill não separa as fases: planejou, construiu e conferiu num só fluxo.
Superpowers é outro framework de spec-driven, rodado com o mesmo pedido e as mesmas respostas fixas. O prompt mandou seguir cada passo do framework, sem nenhuma informação de produto a mais. O agente fez a pergunta, o design em 4 seções aprovadas, a spec, o plano e a execução com implementador e revisor por task. O escopo ficou completo (22 de 22). Perdeu pontos onde o framework não tem gate:
a tela transborda a 1024 px e não foi comparada com o design;
busca, filtro e ordenação ficaram na tela, sem teste (4 de 10 mutações mortas);
o relato declarou pronto com a tela cortada.
tlc-spec-driven: com o mesmo modelo, foi de 84.3 para 98.5 no mesmo tempo. O ganho veio das perguntas e da tela conferida no tamanho real.
tlc-spec-lean: com o Grok 4.7 high, ficou 16.7 pontos acima da base sem skill.
Compactação: numa run em que o contexto foi compactado de verdade, o agente retomou o Verifier e o juiz que já estavam rodando, em vez de despachar outros, e terminou com o gate verde.
Referências que sugiro ler
As decisões deste release seguem o que os próprios fabricantes de modelos recomendam para a geração atual.
Frontend
Anthropic, Prompting Claude Opus 5.5: o modelo lê screenshots com muito mais precisão, inclusive o que depende de posição. Sem direção de design, ele cai nos estilos padrão dele.
Anthropic, Claude Code best practices: a verificação de UI recomendada é tirar um screenshot do resultado, comparar com o design, listar as diferenças e corrigir. Para segunda opinião, um subagente verificador.
Menos instrução e verificação mais barata
Anthropic, Reducing cost and improving performance: rituais de verificação, reforços como "CRITICAL / YOU MUST", passos fixos obrigatórios e regras contraditórias são anti-padrões. Remover esses padrões baixou o custo e subiu a acurácia.
Anthropic, The new rules of context engineering: o system prompt do Claude Code foi cortado em 80% sem perda nas evals.
OpenAI, GPT-5.6 prompt guidance e GPT-5 prompting guide: simplificar primeiro e manter só o resultado esperado, o critério de sucesso, a condição de parada e as restrições. Regras conflitantes causam mais instabilidade do que detalhe faltando.
Google, Gemini 3 developer guide: ser conciso, porque o modelo pode analisar demais técnicas de prompt verbosas feitas para modelos antigos.
Compactação e runs longas
Anthropic, Effective harnesses for long-running agents: uma run longa atravessa várias janelas de contexto guardando o estado em arquivos e no git, não na conversa.